¶ Trino 커넥터
¶ 카탈로그
Trino 는 데이터 소스를 카탈로그로 본다. etc/catalog/<이름>.properties 파일 하나가 카탈로그 하나이고, 파일 이름이 SQL 에서 쓰는 카탈로그 이름이 된다[1].
SELECT * FROM <카탈로그>.<스키마>.<테이블>;
connector.name이 소스 종류를 정한다. 같은 종류를 여러 개 붙이려면 파일을 여러 개 만든다 (mariadb_a.properties,mariadb_b.properties).- 파일 이름에
-를 쓰면 SQL 에서 따옴표로 감싸야 하므로_를 쓴다. - 카탈로그 파일은 전체 노드에 같은 내용으로 두고, 바꾸면 전체 노드를 재시작한다.
/opt/trino/bin/launcher restart
내장 커넥터 목록은 공식 문서에 있다 — BigQuery · Cassandra · ClickHouse · Delta Lake · Druid · Elasticsearch · Hive · Hudi · Iceberg · Kafka · MariaDB · MongoDB · MySQL · Oracle · PostgreSQL · Redis · SQL Server · TPC-H 등. 커넥터는 릴리스마다 더해지고 빠지므로 쓰기 전에 현재 번호의 문서를 본다.
¶ RDBMS
¶ MariaDB
connector.name=mariadb
connection-url=jdbc:mariadb://mariadb.example.net:3306
connection-user=${USER}
connection-password=${PASSWORD}
¶ MySQL
connector.name=mysql
connection-url=jdbc:mysql://mysql.example.net:3306
connection-user=${USER}
connection-password=${PASSWORD}
¶ PostgreSQL
PostgreSQL 은 URL 에 데이터베이스 이름이 들어간다. 데이터베이스마다 카탈로그를 따로 만든다.
connector.name=postgresql
connection-url=jdbc:postgresql://pg.example.net:5432/mydb
connection-user=${USER}
connection-password=${PASSWORD}
¶ SQL Server
connector.name=sqlserver
connection-url=jdbc:sqlserver://mssql.example.net:1433;encrypt=false
connection-user=${USER}
connection-password=${PASSWORD}
¶ Oracle
connector.name=oracle
connection-url=jdbc:oracle:thin:@//oracle.example.net:1521/ORCLPDB1
connection-user=${USER}
connection-password=${PASSWORD}
# precision 없는 NUMBER 를 매핑할 scale. 없으면 그 컬럼이 보이지 않는다
oracle.number.default-scale=10
# scale 을 넘는 값의 처리
oracle.number.rounding-mode=HALF_UP
Oracle 의 NUMBER 를 precision 없이 선언한 컬럼은 oracle.number.default-scale 이 없으면 Trino 에서 보이지 않는다.
¶ NoSQL · 캐시
¶ MongoDB
connector.name=mongodb
mongodb.connection-url=mongodb://${USER}:${PASSWORD}@mongo.example.net:27017/
¶ Redis
connector.name=redis
redis.nodes=redis.example.net:6379
redis.table-names=
¶ Hive (HDFS)
Hive Metastore 의 Thrift 주소와 파일 시스템 종류를 지정한다. HDFS 를 쓰면 fs.hadoop.enabled=true 와 Hadoop 설정 파일이 필요하다[2]. HA NameNode 면 core-site.xml · hdfs-site.xml 이 없으면 nameservice 를 풀지 못한다.
connector.name=hive
hive.metastore.uri=thrift://metastore.example.net:9083
fs.hadoop.enabled=true
hive.config.resources=/etc/hadoop/conf/core-site.xml,/etc/hadoop/conf/hdfs-site.xml
hive.security=allow-all
connector.name=hive-hadoop2 는 옛 이름이다. 현행에서는 hive 다.
¶ Iceberg
¶ Hive Metastore 카탈로그 (HDFS)
connector.name=iceberg
iceberg.catalog.type=hive_metastore
hive.metastore.uri=thrift://metastore.example.net:9083
fs.hadoop.enabled=true
hive.config.resources=/etc/hadoop/conf/core-site.xml,/etc/hadoop/conf/hdfs-site.xml
iceberg.file-format=PARQUET
iceberg.compression-codec=ZSTD
¶ JDBC 카탈로그 (PostgreSQL)
Hive Metastore 없이 RDBMS 에 메타데이터를 둔다[3].
connector.name=iceberg
iceberg.catalog.type=jdbc
iceberg.jdbc-catalog.catalog-name=trino
iceberg.jdbc-catalog.driver-class=org.postgresql.Driver
iceberg.jdbc-catalog.connection-url=jdbc:postgresql://pg.example.net:5432/iceberg
iceberg.jdbc-catalog.connection-user=${USER}
iceberg.jdbc-catalog.connection-password=${PASSWORD}
iceberg.jdbc-catalog.default-warehouse-dir=hdfs://nameservice1/trino/warehouse
fs.hadoop.enabled=true
hive.config.resources=/etc/hadoop/conf/core-site.xml,/etc/hadoop/conf/hdfs-site.xml
| 속성 | 값 |
|---|---|
iceberg.catalog.type |
hive_metastore(기본) · glue · jdbc · rest · nessie · snowflake |
iceberg.file-format |
PARQUET(기본) · ORC · AVRO |
iceberg.compression-codec |
ZSTD(기본) · NONE · SNAPPY · LZ4 · GZIP |
¶ 오브젝트 스토리지 (MinIO · S3)
S3 호환 스토리지는 네이티브 S3 파일 시스템을 켠다[4]. 속성 이름은 fs.s3.enabled 다 (옛 fs.native-s3.enabled 는 이름이 바뀌었다).
connector.name=iceberg
hive.metastore.uri=thrift://metastore.example.net:9083
fs.s3.enabled=true
s3.endpoint=https://minio.example.net:9000
s3.region=us-east-1
s3.path-style-access=true
s3.aws-access-key=${ACCESS_KEY}
s3.aws-secret-key=${SECRET_KEY}
Hive 커넥터로 S3 를 읽을 때도 같은 fs.s3.* · s3.* 속성을 쓴다.
¶ Kudu — 473 에서 제거됨
Trino 473(2025-03-19)에서 Kudu 커넥터가 삭제됐다[5]. 483 에는 없다. 472 이하에서 쓰던 설정은 다음과 같았다.
¶ Trino 472 이하
connector.name=kudu
kudu.client.master-addresses=kudu-master-01:7051,kudu-master-02:7051,kudu-master-03:7051
# 스키마를 Kudu 테이블 이름의 접두사로 흉내낼지. false 면 default 스키마 하나
kudu.schema-emulation.enabled=false
위 버전과 저장소는 오래된 것이라 저장소가 존재하지 않을 수 있다. 현행 Trino 에서 Kudu 를 질의하려면 Impala 를 쓰거나, Kudu 데이터를 Iceberg 등으로 옮긴다.
¶ S3 위의 Hive Metastore 직접 구성
S3 데이터를 Hive 커넥터로 읽으려면 메타스토어가 있어야 한다. 파일 기반 메타스토어는 개발용이라 테이블 생성이 안 되는 경우가 있어, Hive Standalone Metastore 를 직접 띄운 기록이다.
¶ Hive Metastore 3.1.2 + Hadoop 3.3.3 (2022년 테스트 됨)
MariaDB 에 메타스토어 DB 를 만든다.
CREATE DATABASE hive;
CREATE USER 'hive'@'%' IDENTIFIED BY '${PASSWORD}';
GRANT ALL PRIVILEGES ON hive.* TO 'hive'@'%';
FLUSH PRIVILEGES;
Hadoop 과 Standalone Metastore 를 받아 푼다.
wget https://archive.apache.org/dist/hadoop/common/hadoop-3.3.3/hadoop-3.3.3.tar.gz
tar xzf hadoop-3.3.3.tar.gz
wget https://repo1.maven.org/maven2/org/apache/hive/hive-standalone-metastore/3.1.2/hive-standalone-metastore-3.1.2-bin.tar.gz
tar xzf hive-standalone-metastore-3.1.2-bin.tar.gz
apache-hive-metastore-3.1.2-bin/conf/hive-env.sh
export JAVA_HOME=/opt/jdk-17
export HIVE_HOME=/opt/apache-hive-metastore-3.1.2-bin
export HIVE_CONF_DIR=$HIVE_HOME/conf
export HADOOP_HOME=/opt/hadoop-3.3.3
apache-hive-metastore-3.1.2-bin/conf/hive-site.xml
<configuration>
  <property><name>javax.jdo.option.ConnectionURL</name><value>jdbc:mysql://mariadb.example.net:3306/hive</value></property>
  <property><name>javax.jdo.option.ConnectionDriverName</name><value>com.mysql.cj.jdbc.Driver</value></property>
  <property><name>javax.jdo.option.ConnectionUserName</name><value>hive</value></property>
  <property><name>javax.jdo.option.ConnectionPassword</name><value>${PASSWORD}</value></property>
  <property><name>hive.metastore.event.db.notification.api.auth</name><value>false</value></property>
  <property><name>fs.s3a.access.key</name><value>${ACCESS_KEY}</value></property>
  <property><name>fs.s3a.secret.key</name><value>${SECRET_KEY}</value></property>
  <property><name>fs.s3a.endpoint</name><value>http://minio.example.net:9000</value></property>
  <property><name>fs.s3a.path.style.access</name><value>true</value></property>
  <property><name>fs.s3a.connection.ssl.enabled</name><value>false</value></property>
</configuration>
라이브러리를 맞춘다. guava 충돌과 S3A 의존성 때문이다.
cd apache-hive-metastore-3.1.2-bin
rm lib/guava-19.0.jar
cp ../hadoop-3.3.3/share/hadoop/common/lib/guava-27.0-jre.jar lib/
cp ../hadoop-3.3.3/share/hadoop/tools/lib/hadoop-aws-3.3.3.jar lib/
cp ../hadoop-3.3.3/share/hadoop/tools/lib/aws-java-sdk-bundle-*.jar lib/
스키마를 만들고 띄운다.
bin/schematool -initSchema -dbType mysql
nohup bin/start-metastore > logs/metastore.log 2>&1 &
Trino 쪽 카탈로그.
connector.name=hive
hive.metastore.uri=thrift://metastore.example.net:9083
fs.s3.enabled=true
s3.endpoint=http://minio.example.net:9000
s3.path-style-access=true
s3.aws-access-key=${ACCESS_KEY}
s3.aws-secret-key=${SECRET_KEY}
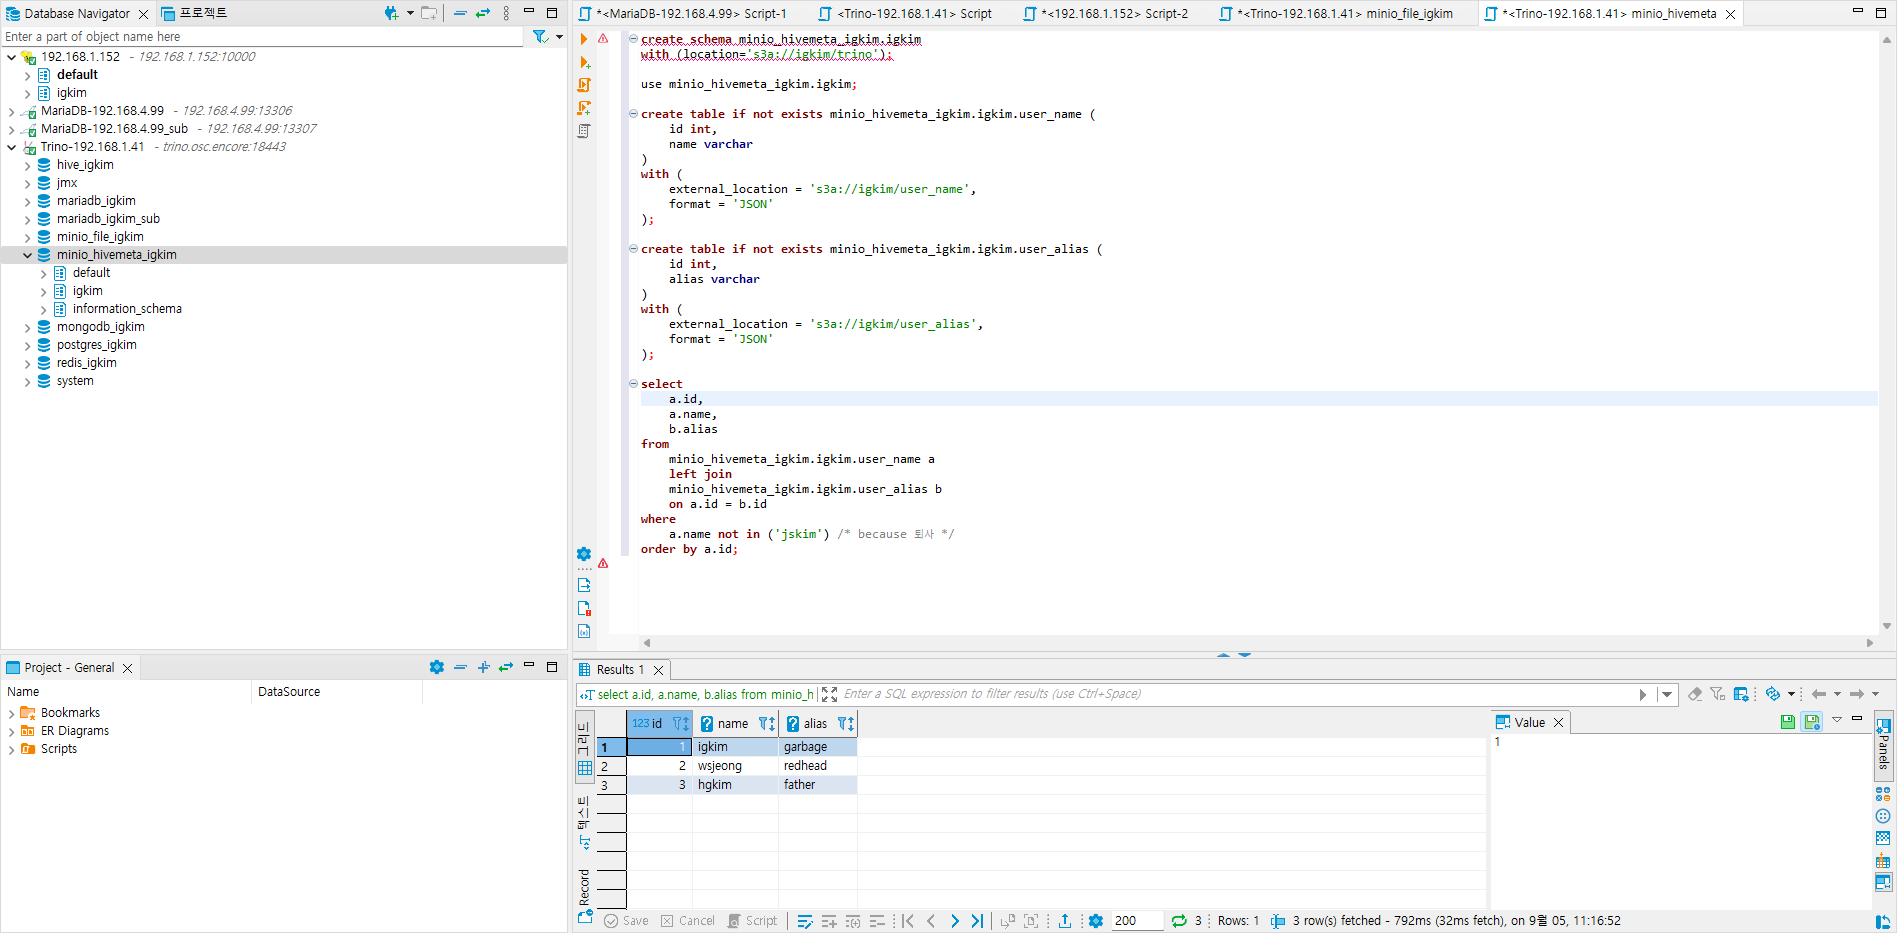
시험 데이터와 질의.
CREATE SCHEMA minio.test WITH (location = 's3a://bucket/trino');

CREATE TABLE IF NOT EXISTS minio.test.user_name (id int, name varchar)
WITH (external_location = 's3a://bucket/user_name', format = 'JSON');

CREATE TABLE IF NOT EXISTS minio.test.user_alias (id int, alias varchar)
WITH (external_location = 's3a://bucket/user_alias', format = 'JSON');

SELECT a.id, a.name, b.alias
FROM minio.test.user_name a
LEFT JOIN minio.test.user_alias b ON a.id = b.id
ORDER BY a.id;
위 버전과 저장소는 오래된 것이라 저장소가 존재하지 않을 수 있다. 당시 Trino 392 는
connector.name=hive-hadoop2와hive.s3.*속성을 썼다. 현행은 위 예시처럼hive와fs.s3.enabled·s3.*다.
Connectors — 2026-09-20 확인. https://trino.io/docs/current/connector.html ↩︎
Hive connector · HDFS file system — 2026-09-20 확인. https://trino.io/docs/current/connector/hive.html · https://trino.io/docs/current/object-storage/file-system-hdfs.html ↩︎
Iceberg connector · Metastores(JDBC catalog) — 2026-09-20 확인. https://trino.io/docs/current/connector/iceberg.html · https://trino.io/docs/current/object-storage/metastores.html ↩︎
S3 file system support — 2026-09-20 확인. https://trino.io/docs/current/object-storage/file-system-s3.html ↩︎
"Breaking change: Remove the Kudu connector. (#24417)" — Trino 473 릴리스 노트. 2026-09-20 확인. https://trino.io/docs/current/release/release-473.html ↩︎